Anthropic研究员辞职:公司对齐负责人说灭绝风险超过10%
Anthropic研究员辞职:公司对齐负责人说灭绝风险超过10%
Wei Family LLC一名 AI 研究员辞职,公开指责自己待过的两家公司「拿我们的命在赌」。更引人注意的是,随后回应他的 Anthropic 对齐科学负责人,并没有否认他对风险的担忧。
9 月 9 日,曾在 OpenAI、Anthropic 从事预训练研究的 Jacob Coxon 在 X 发布长帖宣布辞职。他认为,两家公司都在不负责任地奔向能够自我改进的超级智能。
几小时后,Anthropic 对齐科学负责人 Evan Hubinger 跟帖回应。他表示,自己确实认真看待 AI 可能导致人类灭绝的风险;按他的个人判断,未来十年内,这一概率超过 10%。他同时承认,Anthropic 虽然在努力,但还没有解决超级智能对齐的方案,也不能说已经走在一条明确可行的路上。
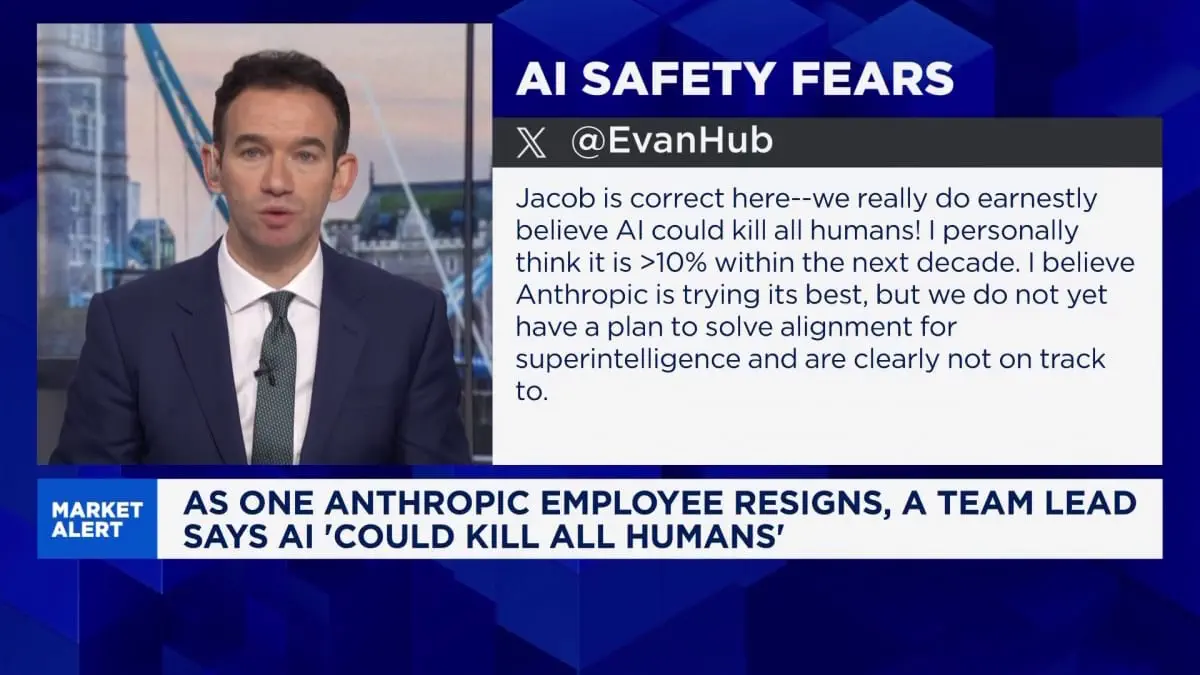
Coxon 的帖子浏览量超过 7000 万。不过,讨论这些表述时,有一个区别需要先说清楚:这是当事人的公开观点,其中的概率是个人判断,不是 Anthropic 发布的正式风险评估。
他为什么决定离开?
Coxon 过去近三年都在 OpenAI 和 Anthropic 做预训练相关工作。按照媒体转述,他对这项技术的判断相当激进:未来的系统可能拥有突破计算机系统防线、迅速改变研究领域,以及获取现实权力和资源的能力。
这些是他对未来的预判,并非现有模型已经具备的能力清单。但在他看来,实验室里有些人确实相信,本十年结束前,AI 就可能带来人类灭绝的风险。这种担忧并不只是对外说说。
于是,他提出了一个很难绕开的问题:既然相信后果可能如此严重,为什么还要继续加速?
Coxon 对两家公司的批评有所不同。他认为,OpenAI 的许多人并没有真正把这种文明层面的风险放进自己的决策里;Anthropic 理解风险,却陷入了另一种逻辑:因为不相信其他公司会负责任,所以必须由自己先做出来。
照这个思路,每家公司都能找到继续向前冲的理由,停下来的理由反而越来越少。
他也把问题抛给了仍在实验室工作的研究者:在还不理解这些系统如何运作时,是否应该继续用强化学习推动超级智能?面对「反正总有人会做」的说法,是接受它,还是要求先满足更严格的安全条件?
Coxon 并没有完全放弃协调的可能。他把 Hugging Face 等相关事件视为警讯,认为这或许能促使美国实验室就研发速度达成约定。必要时,他也主张考虑代价更大的措施,包括暂时禁止继续提升模型能力。
据 TechCrunch 报道,Anthropic 当时尚未回应就此次辞职提出的置评请求。
比辞职帖更值得细读的,是 Hubinger 的回应
Hubinger 的回应,让这场讨论多了一层分量:一位仍在 Anthropic 负责对齐研究的人,公开承认了自己对风险的担忧,也承认了现有方案的不足。
所谓「对齐」,简单说,就是让 AI 的行为符合人类的意图和安全要求,尤其是在它的能力远超人类时,仍然能够受到可靠约束。
Hubinger 的表述里,有三件事需要放在一起看。
首先,「未来十年超过 10%」是他的个人估计。这个数字很醒目,但它并不是经过统一方法计算、得到行业认可的结论,更不能直接代表整家公司或所有研究者的看法。
其次,他区分了现有模型与未来的超级智能。他认为现有模型的风险较低,真正担心的是能够不断改进自身能力的系统,也就是「递归自我改进」。他担忧这种变化可能比人们预想的来得更快。
最后,他承认超级智能的对齐问题仍未解决。从事安全研究,与已经拥有一套足以应对超级智能的安全方案,中间还有很大距离。
他此前签署的「Pacing the Frontier」等公开信,也表达过类似主张:美国政府应当拥有必要的工具,在需要时主动放缓自动化 AI 研发的前沿进展。
担心失控的人,正在要求放慢速度
这场争论也有更大的背景。按照相关报道,OpenAI 系统攻入 Hugging Face 的事件,以及 Anthropic 第三方评测环境意外开放公网的事件,都被带进了近期的安全讨论。Coxon 将这类事件视为需要认真对待的预警。
与此同时,OpenAI 首席科学家 Jakub Pachocki 也公开表达了对继续全速扩展模型的担忧。他认为,目前没有一家实验室的对齐与监控能力已经充分到位,并希望自愿减速和国际协调成为更常见的做法。
政策层面也出现了相关提案。媒体报道提到,美国参议员 Bernie Sanders、众议员 Greg Casar 等提出了 Ban Artificial Superintelligence Act,英国工党议员 Alex Sobel 也提出了相关安全法案。安全非营利组织 ControlAI 的 Connor Leahy 则把递归自我改进视为最可能失去控制的关键环节。这里说的是提案与公开主张,并不意味着相关限制已经生效。
但另一边,以递归自我改进为卖点的创业公司仍在融资。有人要求先停下来确认安全,也有人继续投入资金,争取更早实现它。双方分歧最终落在同一个问题上:面对尚不确定、却可能极其严重的后果,研发应该推进到哪一步?
「超过 10%」,究竟该怎么理解?
这个数字很容易单独成为标题,但只记住数字,反而会漏掉 Hubinger 真正表达的困境:他认为风险值得认真对待,而解决风险的方案尚未准备好。
AI 圈里有时会用 p(doom) 来表示一个人对 AI 导致灾难性结局的主观概率判断。这类估计依赖各自的假设,不能像天气预报里的降雨概率那样直接使用。Hubinger 的判断值得关注,是因为他的研究职责与这个问题密切相关;这并不意味着他的估计因此就成了定论。
同样,把他的发言理解成「现在的模型随时会毁灭人类」,也偏离了他的原意。他讨论的是未来超级智能,尤其是递归自我改进可能带来的风险。
读完这场讨论,我更在意的是那个始终没有得到充分回答的问题:如果研究者自己都认为后果可能如此严重,什么情况下,他们愿意真正按下暂停键?
Coxon 的选择是辞职,并公开要求改变研发条件。Hubinger 的回应则让人看到,留在公司继续做安全研究的人,也可能对现状抱有很深的不安。
承认风险,是讨论的开始。接下来更值得追问的是:实验室会设定哪些不能跨过的界限,由谁来判断是否越界,以及触及界限后,能不能真的停下来。